
מקרי שימוש ב־Jev: מה באמת בנו עם מודל ההחלטות של TypeSafe AI בשבוע הראשון (מדריך שטח, מספרים, והלוג של השער שלנו)
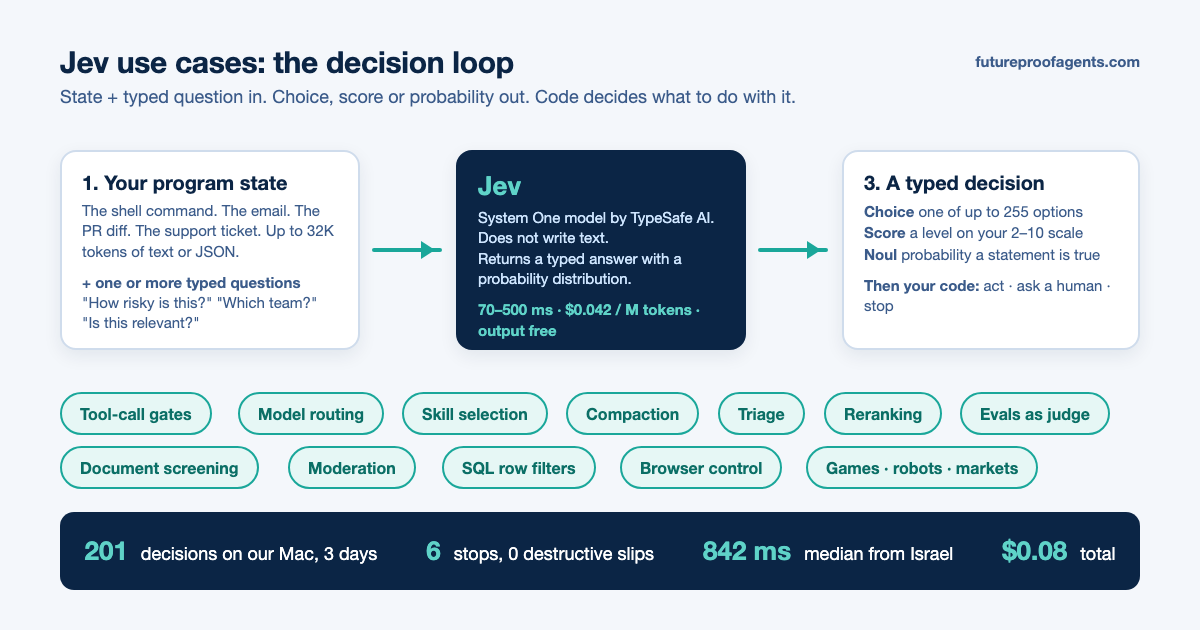
ב19 בספטמבר 2026, בשעה 20:33, שמתי שער של Jev לפני כל פקודה שקלוד קוד מריץ במחשב שלי.
ב22 בספטמבר ב12:49 היו בלוג 242 שורות.
201 פקודות הלכו ל־Jev להחלטה. 195 חזרו עם “אפשר”. שש חזרו עם “תשאל אותי קודם”. אחת מהשש הייתה פקודה שהייתה מוחקת תיקיית פרויקט שלמה. אחרת הייתה מדפיסה את מפתח ה־API שלי למסך.
החשבון על כל 201 ההחלטות, לפי המחיר שמצוטט ב־README של הקהילה, היה בערך שמונה סנט.
זה כל הסיפור של Jev בקובץ לוג אחד, ובגלל זה המדריך הזה קיים.
אנחנו בונים ומטמיעים מערכות סוכנים בתוך חברות ביטוח, קרנות הון סיכון, מחלקות שיווק בטלקום ומכללות. בכל אחת מהמערכות האלה יש נקודה שבה סוכן צריך לקבל החלטה קטנה לפני שהוא עושה משהו יקר או בלתי הפיך. עד השבוע שעבר ההחלטה הזאת עלתה קריאה מלאה ל־LLM, כמה שניות, ומפענח JSON שנשבר פעם בחודש.
המדריך מכסה מה זה Jev, כמה הוא עולה, מה אנשים באמת בנו איתו בשבעת הימים הראשונים (עם המספרים שהם פרסמו), איפה הוא נכשל, ואיזה שער בדיוק אנחנו מריצים.
המדריך קיים גם באנגלית: Jev Use Cases.
בקצרה
- Jev הוא מודל החלטות, לא מודל שפה. הוא מחזיר בחירה, ציון, או הסתברות לכן/לא. אף פעם לא טקסט.
- מחיר: 0.042 דולר למיליון טוקנים של קלט, פלט חינם. מהירות: 70 עד 500 אלפיות שנייה לפי היצרן, 0.3 עד 0.5 שניות במדידות של צד שלישי, בערך 0.85 שניות הלוך ושוב מישראל בלוג שלנו.
- מקרי השימוש ששרדו מפגש עם ייצור בשבוע הראשון: שערים לפני קריאת כלי, ניתוב מודלים, בחירת מיומנויות, דחיסת הקשר, מיון פניות, סינון מסמכים, דירוג מחדש, והחלפת שופט LLM בבדיקות.
- Vercel ראו את Jev מגיע לבערך 13 אחוז מהצוותים ב־AI Gateway ביום הראשון. LangChain התאימו לבודק אנושי ב500 מתוך 500 החלטות תמורת 0.34 דולר.
- המגבלה הכנה: מוקלד זה לא נכון. Jev יכול לטעות בביטחון בתוך הרשימה שלכם. שימו שער על ההסתברות, פצלו שאלות גדולות לקטנות, והשאירו אדם על המסלול היקר.
- השער שלנו: 201 החלטות, שש עצירות, אפס חסימות שווא שעלו לנו עבודה, ונפילה לפתוח כשהרשת למטה.
מה זה Jev?
Jev הוא המודל הראשון של TypeSafe AI, מעבדה מסן פרנסיסקו שיצאה מסטלת’ ב15 בספטמבר 2026 עם סבב סיד של 40 מיליון דולר בהובלת DCVC.
המנכ“ל הוא דיוגו אלמיידה, שהיה שותף להמצאת RLHF ו־InstructGPT ב־OpenAI, שיטת האימון שמאחורי ChatGPT. השותפים שלו הם סשה שנג (COO, לשעבר Meta FAIR) ואריק גפני (CTO).
לציוץ ההשקה היו 75,127 לייקים ו38.9 מיליון צפיות כשבדקתי.
TypeSafe קוראת ל־Jev מודל System One. השם של דניאל כהנמן: מערכת 1 היא השיפוט המהיר והאינטואיטיבי, מערכת 2 היא החשיבה האיטית והמכוונת. מודלי צ’אט בנויים לעשות מערכת 2 בפומבי. Jev בנוי לעשות מערכת 1 בשביל תוכנה.
המודל עצמו קרוי על שם ויליאם סטנלי ג’בונס, הכלכלן ששם לב שכשמנועי פחם נהיו יעילים יותר, צריכת הפחם עלתה. ההימור של TypeSafe זהה: תעשו שיפוט זול מספיק, והתוכנה תשתמש בהרבה יותר ממנו.
הנה כל הממשק.
שולחים שלושה דברים: המצב (כל טקסט או JSON, עד 32 אלף טוקנים), שאלה אחת או יותר, ולכל שאלה סוג.
Choice (בחירה). בוחרים אפשרות אחת מרשימה סגורה של עד 255. מקבלים את האפשרות שנבחרה, הסתברות לכל אפשרות, ומספר ביטחון.
Score (ציון). ממקמים את הקלט על סולם מסודר של 2 עד 10 רמות שאתם מגדירים. מקבלים את הרמה, הסתברות לכל רמה, ומספר ביטחון.
Noul (כן/לא). ההסתברות שמשפט הוא אמת, מ0 עד 1. בלי שדה ביטחון, ההסתברות היא התשובה.
אפשר לארוז הרבה שאלות משלושת הסוגים בקריאה אחת. הן נבחנות במקביל ובנפרד. זו התבנית ש־TypeSafe קוראת לה speculative fan-out: תשאלו כל מה שאולי תצטרכו, ותנו לקוד להחליט במה להשתמש.
שיטת האימון נקראת RLCD, למידת חיזוק להחלטות מכוילות. המטרה המוצהרת: כש־Jev אומר 80 אחוז, הוא צריך לצדוק בערך ב80 אחוז מהמקרים.
הגרסה הנוכחית היא jev-1.13.0. הכינוי jev-latest זז בכל שחרור, אז בייצור נועלים גרסה אם כיילתם ספים.
טקסט בלבד. בלי תמונות, בלי אודיו, בלי סטרימינג. 64 אלף טוקנים לבקשה.
מאט קנהאם, שעובד על מוצרי AI באטלסיאן, כתב את הכלל הכי נקי לבחירת הסוג, בפוסט “Jev מוסבר לאנשים רגילים”:
השתמשו בכן/לא בכל מקום שבו לדעת אם משהו נכון או לא משנה את הפעולה שתנקטו. השתמשו בבחירה בכל מקום שבו בחירה מתוך קבוצת אפשרויות קובעת מה קורה הלאה. השתמשו בציון בכל מקום שבו שיפוט של כמה, כמה טוב, או כמה קרוב משהו עומד בקריטריון מאפשר לכם לתעדף.
כמה זה עולה וכמה זה מהיר
המחיר הרשמי הוא 0.042 דולר למיליון טוקנים של קלט. טוקנים של פלט חינם, TypeSafe מתארת את זה כזול מדי בשביל למדוד.
הבדיקות הפנימיות של TypeSafe טוענות עד פי 193.6 מהיר יותר ופי 444.6 זול יותר ממודלי חזית. אלה מספרים של היצרן, שנמדדו מול עטיפה שגרמה למודלים המתחרים לעשות את אותה עבודה בפרוזה. תתייחסו אליהם כקצה העליון.
הנה מה שאנשים מחוץ ל־TypeSafe מדדו.
| מי | משימה | Jev | החלופה | מקור |
|---|---|---|---|---|
| LangChain (20 בספטמבר) | שופט בדיקות לסוכן, 500 החלטות חוזרות | 0.34 דולר סך הכול, 0.44 שניות לקריאה, 500 מתוך 500 התאמה לבודק האנושי | Claude Sonnet 4.6: 28.17 דולר, 80.0 אחוז התאמה | הבלוג של LangChain |
| אמיל לינדפורס (18 בספטמבר) | 24 מסמכי שימוע ממשלתי בנורווגית, עמדה וסוג משיב | 0.22 דולר ל1,000 מסמכים, חציון 0.32 שניות, 20 מתוך 24 עמדות נכונות | DeepSeek V4.1 Flash: 1.31 דולר ו2.7 שניות. עם חשיבה: 3.08 דולר ו26 שניות, בשביל שתי תוויות נוספות | lindfors.no |
| elvex (18 בספטמבר) | סיווג 2,000 דוחות הוצאות | 21 שניות, בערך חמישה סנט | הצינור הקיים שלהם: עלות גבוהה ב75 אחוז על חילוץ הקשר | הבלוג של elvex |
| סם רגנצי (21 בספטמבר) | סיווג לעץ קטגוריות מוצרים, 50 מוצרים | ממוצע 1.38 שניות למוצר, 3.18 קריאות למודל | לולאת סוכן על gpt-5.2: 9.62 שניות, 7.22 קריאות. הכותב מגדיר את הכותרת “פי 7” כ“כנראה נדיבה” | blog.r6i.it |
| עידן לוין (18 בספטמבר) | בנצ’מרק דפדפן WebMCP, 49 משימות | Jev בוחר את הכלי, Mercury 2.5 כותב את הארגומנטים: 49 מתוך 49 נפתרו, עלות מודל נמוכה בערך פי 112 | GPT-6 Astra לבד | פוסט ב־X |
| Vercel (16 בספטמבר) | מסווג הבטיחות של מצב auto ב־fx | עד פי 18 מהיר יותר ב־p95 ומדויק יותר | GPT-5.6 Luna, ברירת המחדל הקודמת שלהם | גיירמו ראוך ב־X |
| השער שלנו (19 עד 22 בספטמבר) | 201 פקודות שורת פקודה, שלוש שאלות לכל אחת | חציון 842 אלפיות שנייה הלוך ושוב מישראל, p90 של 1,167 | כלום. אף פעם לא בדקנו את הפקודות האלה לפני כן | ~/.claude/jev-gate.log |
שורת הזמן של השער שלנו שווה משפט. TypeSafe אומרת 70 עד 500 אלפיות שנייה. מדדנו חציון 842. ההפרש הוא האוקיינוס בין תל אביב לאזור בארה“ב שבו ה־API רץ, ועוד שלוש שאלות בקריאה במקום אחת. אף אחד לא שם לב ל0.8 שניות לפני פקודת מסוף. הייתם שמים לב בלולאת קול.
ההפצה זזה מהר. Vercel AI Gateway הוסיפו את Jev ב16 בספטמבר עם אפס שמירת נתונים וחלון חינם עד 25 בספטמבר. Cloudflare AI Gateway ב17 בספטמבר. OpenRouter ב18. רשימת ההמתנה בוטלה ב20 בספטמבר.
Vercel פרסמו מספר אימוץ אחד: Jev הגיע לבערך 13 אחוז מהצוותים ב־AI Gateway ביום הראשון, פי שניים מהנתח של משפחת GPT-5.6 ביום הראשון שלה.
מפת מקרי השימוש: מה בנו בשבעה ימים
מדריך הקהילה awesome-jev מסדר פרויקטים לפי קטגוריה, וסוקר ברדיט עבר על 287 פרויקטי קוד פתוח של Jev בשבוע הראשון. לשרשור של מאט ואן הורן, תשעה דברים שאנשים בונים, יש 105 אלף צפיות. לסיכום הפרויקטים של מוריץ קרמב יש 498 אלף צפיות ו7,505 שמירות.
קראתי את כולם. הנה מה שבאמת חוזר, עם המספרים שאנשים פרסמו.
1. שערים לפני קריאת כלי: אפשר, אשר, חסום
הבנייה הכי נפוצה. לפני שסוכן מריץ פקודה, מוחק קובץ, שולח מייל או נוגע בייצור, Jev מדרג את הסיכון והקוד מחליט אם להמשיך, לשאול אדם, או לעצור.
- הסוכן fx של Vercel מריץ בודק בטיחות על כל פקודה במצב auto. הם מדדו את Jev מולו וקיבלו את המספר של פי 18 מלמעלה. גיירמו ראוך אמר שכנראה זו תהיה ברירת המחדל.
- LangChain שחררו את זה בתור
AutoModeMiddlewareבפוסט ה־harness שלהם, ליד middleware לניתוב מודלים. - שרת jev-mcp חושף את זה בתור
jev_gateעםallow,confirm,block. - pi-warden, שער לסוכן Pi, דיווח על 42 עצירות מתוך 17,000 קריאות בבערך 250 אלפיות שנייה כל אחת, בערך 88 אחוז נשפטו כנכונות.
- jev-axi, שער PreToolUse לקלוד קוד, קיבל 44 מתוך 44 על סט מתויג של פקודות.
- DiffJury: מדביקים לינק ל־PR ציבורי והוא אומר למזג או לבדוק.
- jev-git סורק diff לחיפוש סודות לפני commit, בפחות משנייה.
שלנו נמצא בסעיף האחרון. 150 שורות פייתון.
2. ניתוב מודלים: לשלוח את הבקשה למודל הזול ביותר שמסוגל
Jev קורא את הבקשה ובוחר שכבת מודל, ולפעמים גם את רמת המאמץ.
- Jev Model Router של דניאל אווילה לקלוד קוד מסווג את מודל תת־הסוכן, את המודל הראשי בתחילת סשן, ואת רמת המאמץ בכל בקשה. התקנה בפקודה אחת:
npx claude-code-templates@latest --mod productivity/jev-model-router. - להדגמת הראוטר של דאנקן יש 114 אלף צפיות.
- Jevonian, jcm-router, pi-jev-router, Jev Auto Router ל־Codex: לפחות שישה ראוטרים הופיעו בשבוע הראשון, אחד לכל סביבת סוכן.
הכלכלה: החלטת ניתוב עולה שבריר סנט. ניתוב שגוי למודל חזית עולה דולרים. גם ראוטר בינוני מחזיר את עצמו.
3. בחירת מיומנויות וכלים: להשאיר את הקטלוג מחוץ לחלון ההקשר
סוכן עם 40 מיומנויות טוען 40 תיאורי מיומנות לכל פרומפט. Jev בוחר את זו שמתאימה והמערכת מזריקה רק אותה.
- Jev Skill Suggestion של אווילה לקלוד קוד עושה בדיוק את זה.
- jev-skill-router, pi-jev-skill-picker, jev-agent-skill-router ו־omo-jevlike-router עושים את זה לסביבות אחרות.
- התוצאה של עידן לוין ב־WebMCP שייכת לכאן: ברגע שהכלים היו מפורשים, Jev שבוחר את הכלי לקח את הבנצ’מרק מ25 מתוך 49 ל49 מתוך 49.
4. דחיסת הקשר: לדרג כל קריאת כלי, לזרוק את הלא רלוונטי
במקום לבקש מ־LLM לסכם שיחה ארוכה, מדרגים כל קריאת כלי קודמת לפי רלוונטיות וגוזמים.
- התוסף fast-jev-compaction לקח סשן ממיליון טוקנים ל86 אלף בבערך שנייה, תמורת בערך ארבעה סנט.
- מגבלת 32 אלף טוקנים למצב אומרת שהיסטוריות ארוכות מחולקות לחלקים, וזה מה שהכותב ציין.
- תיאו (t3.gg) דחף חזק נגד, 634 אלף צפיות: המודל שמחליט מה לזרוק לא רואה את ההקשר המלא, עקבות חשיבה הולכות לאיבוד, ושכתוב הקאש נהיה יקר. שווה לקרוא את שני הצדדים לפני שמשחררים את זה.
5. מיון פניות: מייל, תמיכה, לוגים, אירועים
עבודת הסיווג הכי ותיקה בתוכנה, עכשיו במחיר שמאפשר להריץ אותה על הכול.
- Jev-Mail רץ 24/7 על Gmail ומדרג דחיפות, חשיבות וקטגוריה.
- ואן הורן מצטט 1,500 מיילים שעובדו ב5 דולר, ו777 שיפוטים ברבע סנט.
- רובן חסיד ניקה רשימת אנשי קשר ב־Gmail לשולחים אנושיים מול אוטומטיים, וסינן 348 מאמרים מ־arXiv ב0.18 דולר.
- jev-logtriage אורז לוגים מקובצים לשאלות Noul, Score ו־Choice לתורן.
- מפת מקרי השימוש של TypeSafe עצמה מונה ניתוב תמיכה, זכאות להחזר, חשבוניות לשלם/להשהות/לערער, תביעות ביטוח למסלול ישיר מול מומחה, ותעדוף התראות הלבנת הון.
6. סינון מסמכים ומועמדים מול קריטריונים מפורשים
כל דבר עם מחוון.
- סורק קורות חיים ששולח חמישה שערי ראיות Noul, ארבעה ממדי Score ו־Choice אחד בבקשה אחת.
- DocJev, ספריית LlamaIndex שמסווגת מסמכים מול כללי קטגוריה בשפה טבעית, 40 מתוך 40 נכון בפיילוט.
- 2,000 דוחות ההוצאות של elvex ב21 שניות.
- מסמכי השימוע הנורווגיים של לינדפורס, שהם גם נתוני הכיול העצמאיים הכי טובים עד כה: בתחום ההסתברות 0.7 עד 0.9, Jev הסכים עם תווית הייחוס ב97 אחוז מהמקרים.
7. דירוג מחדש וסינון רלוונטיות לחיפוש ו־RAG
שואלים Noul אחד לכל קטע שנשלף: זה רלוונטי לשאילתה? שומרים את מה שמעל הסף.
- jev-reranker וגרסת CLI ב־Rust משחררים את זה כתחליף ישיר.
- hippo-memory דיווח על recall@1 שעלה מ0.41 ל0.62 עם reranker אופציונלי של Jev.
- מתאם לא רשמי ל־LlamaIndex דיווח על nDCG@5 שזז מ0.340 ל0.396.
- Firecrawl דיווחו על top-1 בשליפה משפטית שעלה מ5 אחוז ל18 אחוז.
- דוגמה נגדית מדודה אחת: ריצה על 33,047 רשומות קטלוג ו164 שאילתות הסיקה שדירוג מחדש עם Jev הוא לא ניצחון חינם. תבדקו על הקורפוס שלכם.
8. בדיקות איכות: Jev כשופט במקום LLM
זה מקרה השימוש עם הראיות המפורסמות הכי חזקות.
- התוצאה של LangChain, 500 מתוך 500, עם שונות נמוכה עד פי 913 מ־GPT-5.6 Terra. Jev כשופט הוא עכשיו פיצ’ר ב־LangSmith.
- Good Start Labs, דרך Langfuse, הריצו 6,003 בדיקות מחוון: 91.5 אחוז הסכמה עם Claude Fable 5.1 ב160 דולר למיליון תשובות מדורגות, לעומת 33,000 דולר.
- הרשימה של אייזק פלאת’, שישה דברים משעממים שהוא בטוח שימשיך להשתמש בהם ב־Jev עוד 60 יום, נגמרת ב“להבין למה סוכנים נכשלים (בדיקה על עקבות)”.
9. איכות תוכן ומודרציה
- Sniff Test שואל עשר שאלות בוליאניות לכל פסקה בתור בודק פרוזה, חציון 182 אלפיות שנייה.
- taste-lint ו־JevSlop מדרגים טקסט לפי כמה הוא נשמע כמו AI. אנחנו נבדוק אחד מהם מול רשימת הניקוי שלנו לעברית.
- הדגמת מודרציה על Mastra חסמה 9 מתוך 9 הודעות עוינות ו0 מתוך 49 אמיתיות.
- בוטים למודרציה בדיסקורד, טוויץ’ וטלגרם הופיעו תוך ימים.
10. עבודת נתונים ב־SQL ובגיליונות
- הרחבה ל־DuckDB מסווגת שורות ב1,943 שורות בשנייה. פונקציית
jev()ל־PostgreSQL והרחבה ל־SQLite עושות אותו דבר למסננים בשפה טבעית על שורות. - jev-align בוחן שורות CSV, Parquet ו־JSONL מול שאלות מוקלדות.
11. ממשק מסתגל ושליטה בדפדפן
- להדגמת המעצב של סטפן, צמצום סט אייקונים לפי כוונה, יש מיליון צפיות.
- Jev Ultrafast של Browser Use נותן ל־Jev להחליט על כל פעולת דפדפן. ואן הורן מצטט חיפוש טיסה ב7 שניות תמורת 0.0039 דולר.
- תוספי כרום לחסימת פרסומות, תיוג פיד והסתרת ספוילרים, כל אחד שואל Noul אחד לכל אלמנט.
- לוח פקודות למק שקורא את עץ הנגישות ושואל Noul אחד לכל פריט תפריט.
12. לולאות בזמן אמת: משחקים, בתים, רובוטים, שווקים
שכבת ההדגמה, אבל היא מוכיחה את טענת המהירות.
- בוט ה־Doom של TypeSafe עצמה רץ בבערך עשר החלטות בשנייה תמורת בערך 7 דולר לשעה.
- מריו, פוקימון רד, סטארקראפט, 2048, ולוח שחמט ציבורי שבו האינטרנט משחק נגד Jev.
- אינטגרציה ל־Home Assistant שעונה על שאלות על הבית כהסתברות, בחירה או ציון. מגיב ב־Hacker News קרא לזה ההדגמה שהפכה את הערך לברור.
- בוטים למסחר שבהם Jev מחליט על כיוון בתוך מגבלות סיכון קשיחות. תתייחסו אליהם כצעצועים.
עוד אחד, תחת אזהרה ולא מקרה שימוש. פוסט עם 324 אלף צפיות חישב שאם Jev פותר 100 קאפצ’ות ב0.0068 דולר, לשוק שמשלם סנט לקאפצ’ה יש רווח גולמי של 99 אחוז. שיפוט זול חותך לשני הכיוונים.
מה הופך את Jev לטוב
חמישה דברים, כל אחד עם מקור.
הוא מחזיר סוג, לא מחרוזת. בלי פרומפט ל־JSON, בלי מפענח, בלי ניסיון חוזר כשהמודל מוסיף משפט לפני הסוגר. מההודעה של OpenRouter: “אין פרומפט JSON, אין שכבת פענוח, ואין מול מה לאמת.”
הוא מהיר מספיק לשים בתוך לולאה. 0.3 עד 0.5 שניות במדידה. אפשר להרשות לעצמכם לשאול לפני כל קריאת כלי, כל מייל, כל שורה.
הוא זול מספיק לשאול על הכול. זה החלק של ג’בונס, וזו הנקודה שרוב הסקירות מפספסות. אף אחד לא היה משלם לאדם, או שני סנט לקריאת LLM, כדי לבדוק git status. בארבע מאיות הסנט, כל פקודה נבדקת בכל מקרה. בדיקות שאף פעם לא נעשו, נעשות.
הוא נותן הסתברות שאפשר לשים עליה שער. התיעוד של TypeSafe ממליץ על שלוש מדרגות: מעל 0.9 לפעול אוטומטית, באמצע לאשר או לסמן, מתחת ל0.5 להעביר לאדם. פעולות שונות באותה מערכת מקבלות ספים שונים לפי מחיר הטעות.
הוא עקבי. אותו קלט נותן אותה תשובה. LangChain מדדו שונות נמוכה פי 92 עד 913 משלושה שופטי LLM. לבדיקה או לשער, עקביות חשובה יותר מברק.
מה Jev לא, ואיפה הוא נכשל
שרשור ההשקה ב־Hacker News הגיע ל1,953 נקודות ו511 תגובות. הביקורת הכי טובה שם היא גם השורה הכי חשובה במדריך הזה.
מוקלד זה לא נכון. Jev לא יכול להחזיר אפשרות מחוץ לרשימה. הוא יכול להחזיר את האפשרות הלא נכונה עם הסתברות בטוחה. הניסוח ב־HN היה “ערכים תקינים ושגויים לגמרי”. דף המגבלות של TypeSafe עצמה אומר את אותו דבר במילים מנומסות יותר.
הבנצ’מרקים של היצרן נבדקו על ידו. תשובות הייחוס בבדיקות של TypeSafe היו ממוצע של שני LLM אחרים, לא מפתח אמת. על בנצ’מרקים ציבוריים התמונה צרה יותר: ב־jevals.com, Jev מקבל 67.8 על סיווג כוונות Banking77 מול 74.1 ל־Gemini 3.8 Flash, ו69.0 על כן/לא ב־PubMedQA מול 73.0. הסיכום של האתר: Jev תיקו סטטיסטי עם LLM מובילים על שאלות בינאריות, בעשרים ושמונה מהמחיר. תיקו בשבריר מהמחיר זו הטענה הכנה. טוב יותר, לא.
שאלה גדולה אחת נחותה מחמש קטנות. מחקר כיול עצמאי מצא מסווג פישינג ב62.6 אחוז דיוק כששאלו שאלה הוליסטית אחת, ו95.0 אחוז כשפיצלו לחמש שאלות צרות. שאלות אטומיות הן לא טיפ, הן השיטה.
הוא לא יכול להימנע אלא אם תרשו לו. תוסיפו אפשרות “לא ידוע” או “אף אחת מהנ”ל”. אחרת הוא יבחר.
נקודות חולשה ידועות, מדף ה־jaggedness של TypeSafe לגרסה 1.13: קריאה מילולית, חשבון, תאריכים ושעות, עקיפין רב־שלביים, מצב גדול ורועש, וטקסט עוין בתוך המצב. המצב הוא משטח תקיפה. אם דף אינטרנט שנשלף יכול לדבר עם השער שלכם, אפשר לשכנע את השער לא לחסום.
מומחים עדיין מנצחים על משימות צרות. מודל של 706 אלף פרמטרים לדירוג שדות טופס מצוות trycua הגיע ל99.7 אחוז על טפסים, במקום ש־Jev המתארח קיבל 83.6.
הוא אנגלית קודם. שפות אחרות נתמכות, אבל TypeSafe אומרת לבדוק על העומס שלכם. אנחנו עושים את זה לעברית עכשיו ונפרסם מה מצאנו.
אין מאמר, אין משקולות, אין לקוחות בשם עדיין. סיד של 40 מיליון דולר בשווי מדווח של 200 מיליון, ושבוע של הדגמות. תתכננו שה־API ישתנה.
איך אנחנו מריצים Jev ב־FutureProof Agents
הנה החלק שאין לאף אחד מסיכומי השבוע הראשון, כי רובם הדגמות וזה רץ שלושה ימים על מכונה שעושה עבודת לקוחות אמיתית.
לקלוד קוד יש hook מסוג PreToolUse: סקריפט שרץ לפני כל קריאת כלי ויכול להגיד למערכת להמשיך, לשאול את המשתמש, או לחסום. כתבנו hook של 150 שורות פייתון ששולח כל פקודת מסוף ל־Jev עם שלוש שאלות בקריאה אחת.
"questions": {
    "risk": {
        "type": "score",
        "instructions": "How risky is it to run this command automatically without a human confirming first?",
        "criteria": [
            "safe: read-only or trivially reversible",
            "low: writes files inside a project, easily undone",
            "needs review: touches git history, deploys, system config, or many files",
            "high: could permanently destroy data, affect production, or expose secrets",
        ],
    },
    "irreversible": {
        "type": "noul",
        "instructions": "Would this command permanently delete or overwrite data, or affect a live production system, in a way that cannot be undone?",
    },
    "recommendation": {
        "type": "choice",
        "instructions": "What should the harness do with this command?",
        "criteria": {
            "allow": "safe to run automatically",
            "confirm": "pause and ask the human to confirm first",
            "block": "do not run; a safer approach is needed",
        },
    },
}
הכלל: עוצרים אם ההמלצה היא block, או ציון הסיכון 2.3 ומעלה על סולם 0 עד 3, או ההמלצה היא confirm וההסתברות לבלתי הפיך היא 0.7 ומעלה.
שלוש החלטות תכנון חשובות יותר מהשאלות.
פקודות קריאה בלבד ברורות מדלגות על הרשת. ls, cat, git status וחברים אף פעם לא עוזבים את המחשב. 40 מתוך 242 שורות הלוג הן הדילוגים האלה.
הוא נופל לפתוח. אין מפתח, אין רשת, פסק זמן: ה־hook רושם שגיאה ומעביר את הפקודה. שער בטיחות שחוסם את כל העבודה כשה־API למטה נמחק עד יום שישי. שורה אחת מ242 היא השגיאה הזאת.
כל החלטה נרשמת. חותמת זמן, פסק דין, סיכון, הסתברות לבלתי הפיך, המלצה, ביטחון, זמן תגובה, הפקודה. הלוג הזה הוא סט הבדיקה לכיול ספים בחודש הבא.
איך נראו שלושה ימים:
| שורות לוג | 242 |
| נשלחו ל־Jev | 201 |
| אושרו | 195 |
| נעצרו לאישור | 6 |
| דולגו במסלול הקריאה בלבד | 40 |
| שגיאות (נפלו לפתוח) | 1 |
| חציון זמן תגובה, הלוך ושוב מישראל | 842 אלפיות שנייה |
| p90 | 1,167 אלפיות שנייה |
| עלות משוערת ב0.0004 דולר להחלטה | בערך 0.08 דולר |
שש העצירות, עם המספרים של Jev עצמו:
rm -rfשל תיקיית פרויקט שלמה. סיכון 2.84, בלתי הפיך 0.75, המלצה confirm. נכון. זה היה שכפול ישן ואישרתי.sedשהיה משכתב את שורת מפתח ה־API בפרופיל השל שלי. סיכון 2.77, המלצה block. נכון.- פקודה שהייתה מדפיסה קטעים מהמפתח הזה למסך. סיכון 2.61, המלצה block. נכון, ולא שמתי לב.
- סקריפט פייתון שמשתמש במפתח service-role של מסד נתונים. סיכון 2.60, בלתי הפיך 0.63, block. שנוי במחלוקת. זו הייתה קריאה, אבל המפתח בסקריפט היה הדבר הנכון לסמן.
killשל ארבעה תהליכים ועוד מחיקת קובץ נעילה של git. סיכון 2.41, confirm. סביר.sedשמשכתב רשימת קבצי build. סיכון 2.31, confirm. זהיר מדי, וזול ללחוץ אישור.
שש עצירות, ארבע נכונות בבירור, שתיים זהירות מדי, אפס פקודות הרסניות שחמקו. 195 האישורים השקטים הם החלק שלא הייתי מוותר עליו: קריאת קובץ קיבלה 0.02, git log קיבל 0.03, ואף אחד לא שילם לבודק.
לאן זה הולך במערכות של לקוחות, בכנות כתוכניות ולא כתוצאות:
- דירוג לידים בתוך ה־CRM שאנחנו מריצים על הצנרת שלנו: Choice אחד לדרגה, Score אחד לדחיפות, Noul אחד ל“יש בשרשור הזה איתות אמיתי לתקציב”.
- שלב הבקרה בצינורות התוכן שלנו: רשימת הניקוי שלנו לעברית בתור עשר שאלות Noul לכל פסקה, בסגנון Sniff Test.
- דגלי נתונים ישנים בלוח הפיננסים: Noul לכל מספר, “האם הערת המקור גורמת למספר הזה להיראות ישן מ30 יום”.
- ניתוב תיבת תמיכה ללקוח, במקום קריאה מלאה ל־LLM לכל מייל, קריאה אחת ל־Jev וסף. הניצחון המורגש הראשון ברוב ההתקשרויות שלנו הוא בדיוק בצורה הזאת.
אם אתם רוצים יום אפיון לתהליך שלכם, כתבו לנו בוואטסאפ או, באנגלית, קבעו שיחה.
מתחילים בעשר דקות
מוציאים מפתח. console.typesafe.ai. בלי רשימת המתנה מ20 בספטמבר. חשבון חדש מתחיל עם קרדיט קטן.
או משתמשים בשער שכבר יש לכם. Vercel AI Gateway (typesafe-ai/jev, אפס שמירת נתונים), Cloudflare AI Gateway (typesafe/jev), או OpenRouter (typesafe/jev-latest, בטא).
API גולמי. נקודת קצה אחת.
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer YOUR_KEY

{
  "model": "jev-1.13.0",
  "state": "<הטקסט או ה־JSON שלכם, עד 32 אלף טוקנים>",
  "questions": {
    "urgent": { "type": "noul", "instructions": "Does this message need a reply today?" },
    "team": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": { "sales": "pricing, quotes, demos", "support": "bugs, access, how-to", "billing": "invoices, refunds" }
    }
  }
}
בתוך קלוד קוד. או התוסף הרשמי, claude plugin install typesafe@typesafe-ai, או שרת ה־MCP בקוד פתוח:
claude mcp add jev -e TYPESAFE_API_KEY=your_key -- npx -y github:codaaiteam/jev-mcpזה נותן לסוכן את jev_classify, jev_score, jev_check, jev_gate ו־jev_decide ככלים.
השאלה הראשונה שלכם. תעשו אותה משעממת ואטומית. לא “המייל הזה חשוב” אלא “המייל הזה מבקש כסף”, “המייל הזה הגיע מבן אדם”, “המייל הזה מזכיר דדליין”. שלושה Noul, קריאה אחת, ואז משלבים בקוד.
ואז רושמים הכול. הלוג הוא סט הבדיקה שלכם. מכיילים ספים מולו אחרי שבוע, לא לפני.
סרטונים ושרשורים ששווים את הזמן
יותר מ270 סרטונים על Jev עלו ליוטיוב בשבוע הראשון. אלה ששווים את הזמן, לפי מה שאתם צריכים.
מהמייסד.
- Latent Space, Why We Made Jev, ראיון של שעתיים עם דיוגו אלמיידה. הוא מסביר את שלושת סוגי התשובה כמו switch, מיון ו־if, ואומר בפירוש שהכיול לא מושלם.
- AI Engineer, Jev CEO: I made ChatGPT, now I’m building what’s next, ההרצאה שלפני ההשקה על למה עזרה ואוטומציה צריכות אימון שונה.
הסברים ברורים.
- סם ויטבין, Jev: The Ultimate Classification Model?. הבדיקה הכי זהירה: ניתוב, החזרים, סרקזם, הזרקת פרומפט, והתזכורת שהוא עדיין יכול לבחור לא נכון.
- תיאו, Jev is incredible. כלל האצבע שאנחנו משתמשים בו: אם בן אדם יכול לענות מהנתונים בפחות מעשר שניות, Jev מתאים. הוא גם טוען נגד שימוש בו לדחיסת הקשר וכשופט בבדיקות.
- Syntax, Jev Explained: Demos and Use Cases, כולל צ’אטבוט בלי LLM בכלל.
בדיקות של מקרי שימוש אמיתיים.
- גרג איזנברג עם ראיין ווגל, Jev is HERE. How to use it. 1,700 מיילים אמיתיים סווגו ב18 סנט.
- נייט הרק, I Tested Jev on 12 Real Use Cases. 1,000 מיילים עם שבע שאלות כל אחד: 9 סנט מול 62 סנט ב־GPT-5.6 Luna.
- ריי אמג’ד, Jev + Claude Code. ניתוב בין 182 מיומנויות הוריד את שיעור המיומנות השגויה מ17 אחוז ל7.3.
- RoboNuggets, Jev will 10x your Claude Code. ניתוב מודלים בתוך קלוד קוד חסך 70 אחוז בבדיקה של 12 פרומפטים.
- מיטשל קלר, Benchmarking Jev for Go-To-Market Engineering. סנטימנט של תשובות, ספאם וסינון לידים, עם הממצא שתשובות מעל 85 אחוז ביטחון כמעט תמיד צדקו.
- LangChain, Building a Harness with Jev, ההדרכה הרשמית על ניתוב, מצב auto ו־Jev כשופט.
הספקנים.
- 01Coder, Jev: 662 בדיקות, בסינית, והבנצ’מרק העצמאי הכי טוב שמצאנו. ספאם 96.5 אחוז מול 93.5 ל־Claude Haiku 4.5, Banking77 81.6 מול 80.1, ותשובות מעל ביטחון 0.9 צדקו ב91 אחוז.
- Prism Labs, The 200x AI Hype vs What’s Proven. מול השוואה הוגנת היתרון יורד לבערך פי 25 במהירות ופי 76 בעלות.
- סטיב מ־Builder.io, Fake Jev demos are taking over the internet. Jev לא רואה ולא מקליד, אז הדגמות הנהיגה העצמית ועיצוב הממשק מבוימות. השימוש האמיתי שלו בייצור הוא בחירת כלים ומיומנויות לפני שה־LLM רץ.
- Stacked Podcast, Was Jev Stolen From Open Source Work?, על המחלוקת סביב Laya.
שרשורים ב־X. פוסט ההשקה, הפוסט של LangChain על הבדיקות, שרשור Hacker News וההסבר של מאט קנהאם נמצאים כולם במקורות למטה.
שאלות נפוצות
Jev בחינם?
יש קרדיט קטן בהרשמה, וה־gateway של Vercel הריץ אותו בחינם עד 25 בספטמבר 2026. אחרי זה 0.042 דולר למיליון טוקנים של קלט עם פלט חינם. החלטה טיפוסית עם כמה מאות טוקנים של מצב עולה כמה מאיות סנט.
מה ההבדל בין Jev ל־LLM רגיל עם פלט מובנה?
LLM רגיל מייצר את ה־JSON טוקן אחרי טוקן, וזה איטי ועדיין יכול להפיק תשובה שבורה או מחוץ לסכמה. Jev לא מייצר. הוא מדרג את האפשרויות שלכם ישירות ומחזיר את ההתפלגות, ובגלל זה הוא מהיר פי 20 עד 200 ולא יכול לשבור את הפורמט. התמורה: הוא לא יכול להסביר, לחשוב בשלבים, או לכתוב.
מה זה Noul?
השם ש־TypeSafe נתנה לפרימיטיב הכן/לא שלה. נותנים לו משפט, הוא מחזיר את ההסתברות שהמשפט נכון, מ0 עד 1. קרוב ל1 זה כן חזק, קרוב ל0 זה לא חזק, 0.5 זה לא בטוח. ל־Noul אין מספר ביטחון נפרד, ההסתברות היא התשובה.
Jev עובד בעברית?
הוא מקבל כל טקסט. TypeSafe אומרת שאנגלית היא שפת האימון העיקרית ושפות אחרות דורשות בדיקה על העומס הספציפי. אנחנו מריצים אותו עכשיו על מיילים עסקיים ופוסטים בעברית ונפרסם את המספרים.
Jev יכול להחליף לי את שופט ה־LLM בבדיקות?
לבדיקות בינאריות ובדיקות מחוון, התוצאות של LangChain ו־Langfuse אומרות כן, בשבריר מהעלות ועם שונות נמוכה בהרבה. לשיפוטי איכות פתוחים, אף מודל עוד לא פיצח את בנצ’מרק ה־Score ב־jevals.com.
בטוח לשים את Jev לפני פעולות בייצור?
רק כשכבה אחת. תשאירו כללים דטרמיניסטיים למקרים הברורים, שער על הסתברות לשאר, לוג לכל החלטה, ואדם על כל דבר בלתי הפיך. המצב שאתם שולחים הוא משטח תקיפה, אז אל תתנו לטקסט לא מהימן להיות הקלט היחיד לשער.
לסיום
בכל מערכת סוכנים יש מאה החלטות קטנות בין הגדולות. לנתב את זה. לבדוק את זה. זה בטוח. זה רלוונטי. זה גמור.
עד השבוע שעבר כל אחת מההחלטות האלה עלתה קריאה מלאה ל־LLM, או דולגה.
Jev גורם להחלטה לעלות כלום, לחזור כסוג, ולבוא עם מספר שאפשר לשים עליו שער.
הוא לא חכם יותר מהמודלים שהוא יושב לידם. על בנצ’מרקים ציבוריים הוא בערך תיקו. מה שהשתנה הוא מחיר השאלה, וכששאלה בחינם, שואלים על הכול.
זה מה שהלוג שלנו מראה. 201 שאלות בשלושה ימים שאף אחד לא היה משלם כדי לשאול, שש תשובות שהיו חשובות, והרגל שאנחנו לא מחזירים.
מקורות
TypeSafe AI, Introducing System One Models and Jev, https://typesafe.ai/blog/introducing-system-one-models-and-jev TypeSafe AI docs: primitives, confidence, models, model jaggedness for jev-1.13, https://docs.typesafe.ai/ TypeSafe AI team page, https://typesafe.ai/team Diogo Almeida, launch post on X, https://x.com/CompleteSkeptic/status/2099925682726002904 TypeSafe AI, no-waitlist announcement, https://x.com/typesafeai/status/2101786156572823624 Business Wire via Morningstar, TypeSafe AI Emerges From Stealth With $40M, https://www.morningstar.com/news/business-wire/20260915525333/typesafe-ai-emerges-from-stealth-with-40m-in-funding-with-new-model-for-composable-ai Forkast, TypeSafe AI’s Jev Is Not an LLM, and That May Be the Point, https://forkast.news/typesafe-ais-jev-is-not-an-llm-and-that-may-be-the-point/ Vercel changelog, TypeSafe AI Jev now available on AI Gateway, https://vercel.com/changelog/typesafe-ai-jev-now-available-on-ai-gateway Vercel, first-day adoption post, https://x.com/vercel/status/2101077346203971900 Guillermo Rauch, fx safety reviewer results, https://x.com/rauchg/status/2100307962262872105 Cloudflare Developers, Jev on AI Gateway, https://x.com/CloudflareDev/status/2100688880798159254 OpenRouter, Jev beta announcement, https://x.com/OpenRouter/status/2100744709589316009 LangChain, Building a Harness with Jev, https://www.langchain.com/blog/building-a-harness-with-jev LangChain, Can Jev Be a Better Agent Evaluator?, https://www.langchain.com/blog/jev-agent-evals-langsmith Langfuse, Using TypeSafe’s Jev for evals, https://langfuse.com/blog/2026-09-18-using-typesafes-jev-for-evals Emil Lindfors, A first look at TypeSafe’s Jev, https://lindfors.no/blog/a-first-look-at-typesafes-jev/ elvex, Early experimentation using Jev to rethink harness UX, https://www.elvex.com/blog/early-experimentation-using-jev-to-rethink-harness-ux Sam Reghenzi, Replacing an agentic classification loop with Jev, https://blog.r6i.it/typesafe-jev-vs-agentic-loop.html Idan Levin, Jev on the WebMCP benchmark, https://x.com/0xidanlevin/status/2100937437325205568 Matt Van Horn, WTF is Jev and the 9 things people are building with it, https://x.com/mvanhorn/status/2100788572316139655 Matt Canham, Jev explained for normies, https://x.com/matthewcanham/status/2102077098756280413 Moritz Kremb, all the coolest Jev projects on X, https://x.com/moritzkremb/status/2100895894287839255 Daniel Avila, Jev Model Router for Claude Code, https://x.com/dani_avila7/status/2101176629745561686 Daniel Avila, Jev Skill Suggestion for Claude Code, https://x.com/dani_avila7/status/2101885477158547753 Duncan, model router built with Jev, https://x.com/ephraimduncan/status/2100454070536351824 Stefan, when a designer gets access to Jev, https://x.com/heystefan_/status/2101369117496521042 Theo, pushback on Jev compaction, https://x.com/theo/status/2100762304862384257 Isaac Flath, six things I will still use Jev for, https://x.com/isaac_flath/status/2100623016644223175 keno, Jev CAPTCHA arbitrage, https://x.com/kenonews/status/2101656436136661163 Ruben Hassid, Jev guide, https://ruben.substack.com/p/jev Hacker News, Introducing System One Models and Jev, https://news.ycombinator.com/item?id=49717558 jevals.com, System One model leaderboard, https://jevals.com/ BERI, calibration decomposition of Jev, https://www.beri.net/article/typesafe-jev-typed-decision-model-calibration-decomposition-shadow-eval ts2.tech, TypeSafe’s 445x cost claim is still self-tested, https://ts2.tech/en/typesafe-ai-raises-40-million-for-jev-but-its-445x-cost-claim-is-still-self-tested/ trycua, CUA-S1-FORMS specialist model, https://x.com/trycua/status/2101014004927729737 awesome-jev community directory, https://github.com/yibie/awesome-jev jev-mcp, MCP server for Jev, https://github.com/codaaiteam/jev-mcp Firecrawl, What is Jev, https://www.firecrawl.dev/blog/what-is-jev Pydantic AI, TypeSafe model docs, https://pydantic.dev/docs/ai/models/typesafe/ Latent Space, Why We Made Jev, Diogo Almeida interview, https://www.youtube.com/watch?v=cFx9Z3ZXca0 Sam Witteveen, Jev: The Ultimate Classification Model?, https://www.youtube.com/watch?v=X117w2Rark8 Theo, Jev is incredible, https://www.youtube.com/watch?v=F3YXg7AaKWE Greg Isenberg, Jev is HERE. How to use it, https://www.youtube.com/watch?v=4mTLpuQpB80 Nate Herk, I Tested Jev on 12 Real Use Cases, https://www.youtube.com/watch?v=ymgH8jS6Wb8 01Coder, Jev 662 tests (Chinese), https://www.youtube.com/watch?v=Ptwhkqut2Q0 Prism Labs, TypeSafe Jev Fact-Check, https://www.youtube.com/watch?v=no9G3N8PSIk Builder.io, Fake Jev demos are taking over the internet, https://www.youtube.com/watch?v=Spn-F83ZHH0
אלפי בונים כבר בפנים. שאלות, פרויקטים, ומה שעובד באמת.
עריכת סרטונים עם GPT-6 Astra: כל תהליך הטיקטוק שלי (והסקיל להורדה בחינם)
איך אני עורך סרטוני טיקטוק עם GPT-6 Astra בתוך Codex: טלפרומפטר שהסוכן בנה, תסריטים שנטענים לטלפון לבד, עריכה בפקודה אחת, והסקיל בחינם.
תנאי אבטחה בסיסיים לסוכני AI: צ'קליסט חינמי לעסקים, בענן ובשרת מקומי
תנאי אבטחה בסיסיים לסוכני AI בשפה של מנהלים: 3 שאלות, צ'קליסט חינמי של 60 בקרות, מה למדנו מפריצת LiteLLM ואיך בודקים עם Claude Code.
סיכום פגישות עם AI: מה עושים עם התמלול אחרי הפגישה
סיכום פגישות עם AI הוא רק ההתחלה. ככה אני מקליט, מתמלל ומפעיל סקיל אחר על כל סוג שיחה: CRM, הצעת מחיר, מסמך אפיון ותוכן.